
Appearance
GPT-6 Sol 和 GPT-6 Luna 正式发布:ChatGPT 国内使用指南
发布日期:2026年9月23日
GPT-6 Sol 和 GPT-6 Luna 正式发布,进一步补全了 GPT-6 模型矩阵。如果说 GPT-6 Astra 摸到了新一代模型的智能上限,Sol 和 Luna 就是把「性价比」推到了新的高度。
OpenAI 沿用了和 GPT-6 Astra 同源的技术路线来训练 Sol 和 Luna,把 Astra 在专业办公、事实准确性、代码编写、计算机操控(Computer Use)以及模型对齐上的能力突破,完整下放到了速度更快、价格更低的模型上。
- GPT-6 全系模型在「成本—智能水平」曲线上均保持领先,每个档位的综合表现都足够能打,同时依托高效的底层基础设施,实现了规模化交付。
- 得益于缓存机制和推理效率的突破,API 的调用成本也大幅下降:Sol 和 Luna 的 API 价格相较 GPT-5.6 促销价直降了 50%。
GPT-6 API 定价
| 模型 | 输入 | 输出 | 价格降幅 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 | $20 → $10 | 降价 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10 | $1.20 → $0.50 | 降价 50% |
GPT-6 Astra 依旧是 OpenAI 综合实力最强的大语言模型。如果你的业务对输出质量和性能有极致要求,它才是最好的选择。
GPT-6 模型家族全方位跨越
在应对高难度、复杂业务工作时,GPT-6 Sol 和 Luna 同时实现了能力提升和性价比跃升。
专业工作场景
GPT-6 Sol 能够胜任高难度的复杂任务,同时凭借更高的用量限额和更低的使用成本,为高频迭代留出了充裕的试错空间;和同价位的竞品模型相比,它的智能水平和任务产出都明显更胜一筹。
在评测跨应用复杂业务工作流的 AutomationBench 基准测试中,开启极高思考预算(xhigh effort)的 GPT-6 Sol 击败了满血思考(max effort)下的 Claude Opus 5,单次任务成本仅为 Opus 5 的 9%。在高思考预算(high effort)下,GPT-6 Luna 相比前代得分提升了 5.4 个百分点,单任务成本降低了 58%。
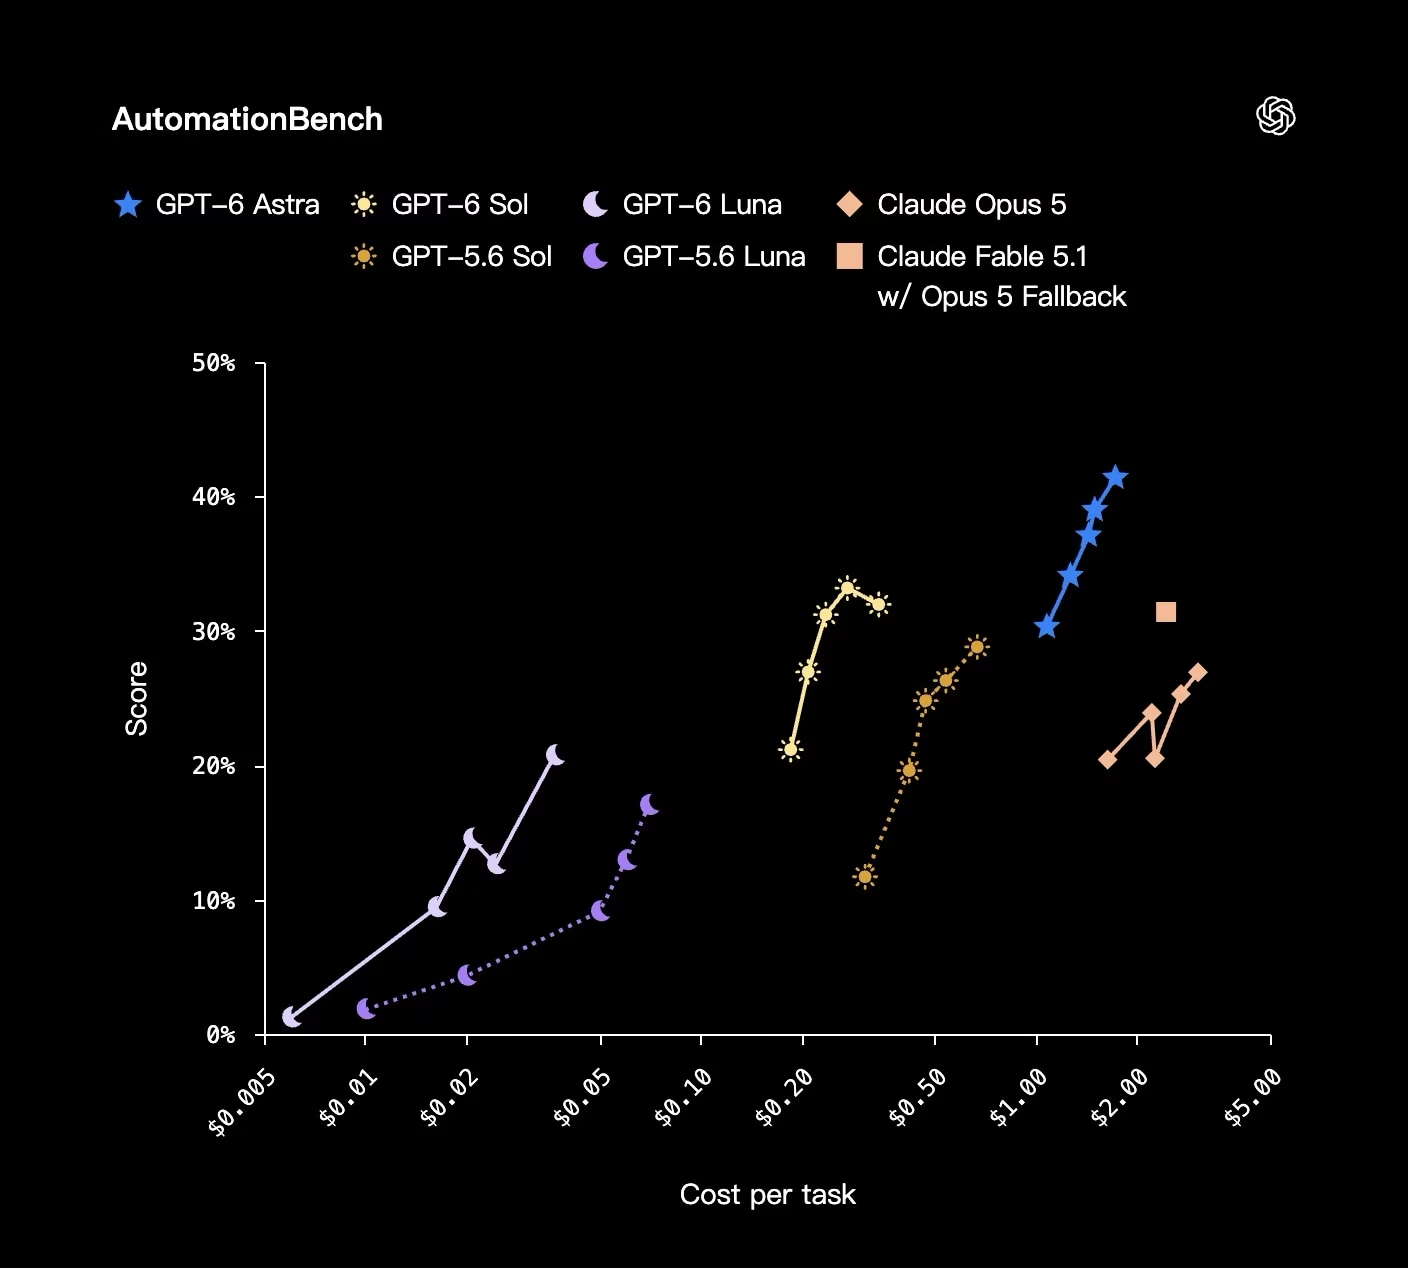
GPT-6 Sol 同样以极低成本超过了 Claude Fable 5.1,得分甚至高于低思考预算(low effort)下的 GPT-6 Astra。
| 模型(及思考预算) | 得分 | 单任务成本 |
|---|---|---|
| GPT-6 Sol (xhigh) | 33.2% | $0.27 |
| GPT-6 Astra (low) | 30.3% | GPT-6 Sol 的 3.9 倍 |
| Claude Opus 5 (max) | 26.9% | GPT-6 Sol 的 11.1 倍 |
| Claude Fable 5.1 w/Opus 5 Fallback (max) | 31.4% | GPT-6 Sol 的 >8.9 倍 |
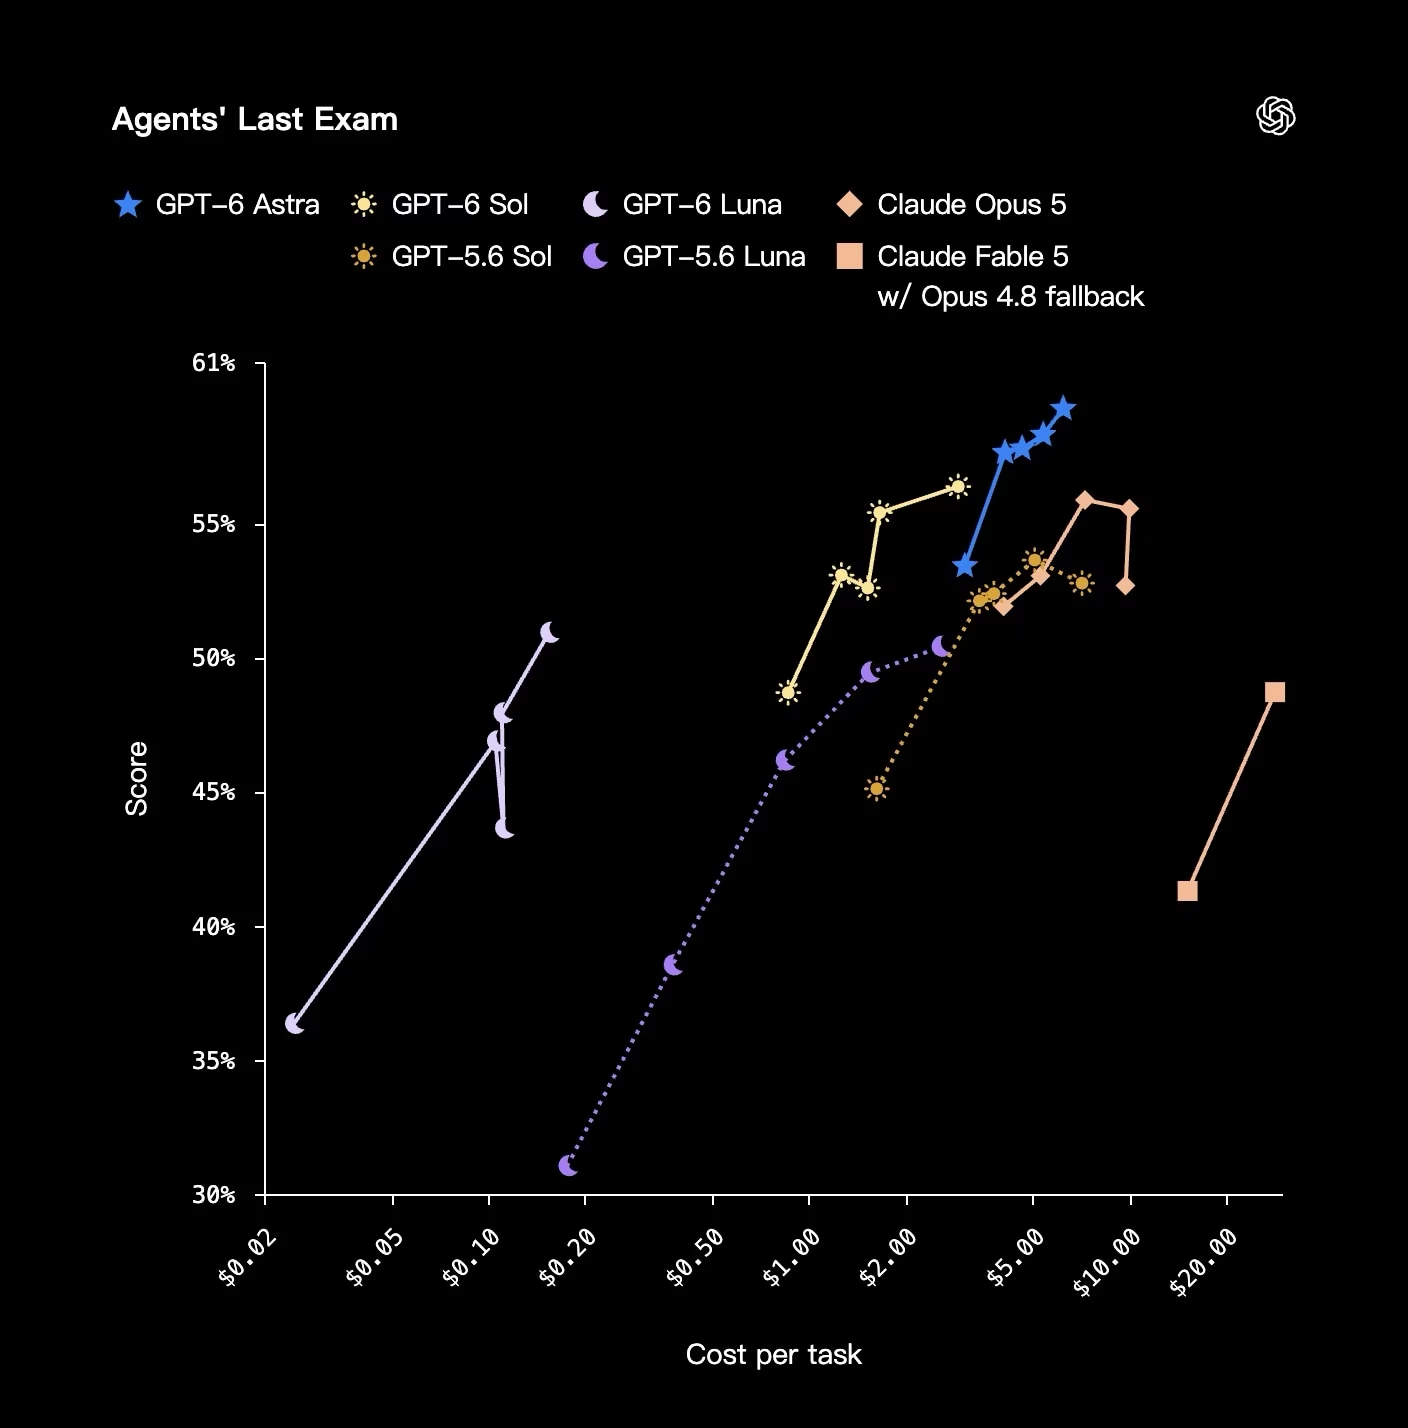
在评估 Agent 复杂专业工作流的权威测试 Agents’ Last Exam 中,开启满血思考(max effort)的 GPT-6 Sol 拿到 56.4% 的高分,超过了 Claude Opus 5 在该评测中的最高成绩,单任务成本还低了 60%。
事实准确性
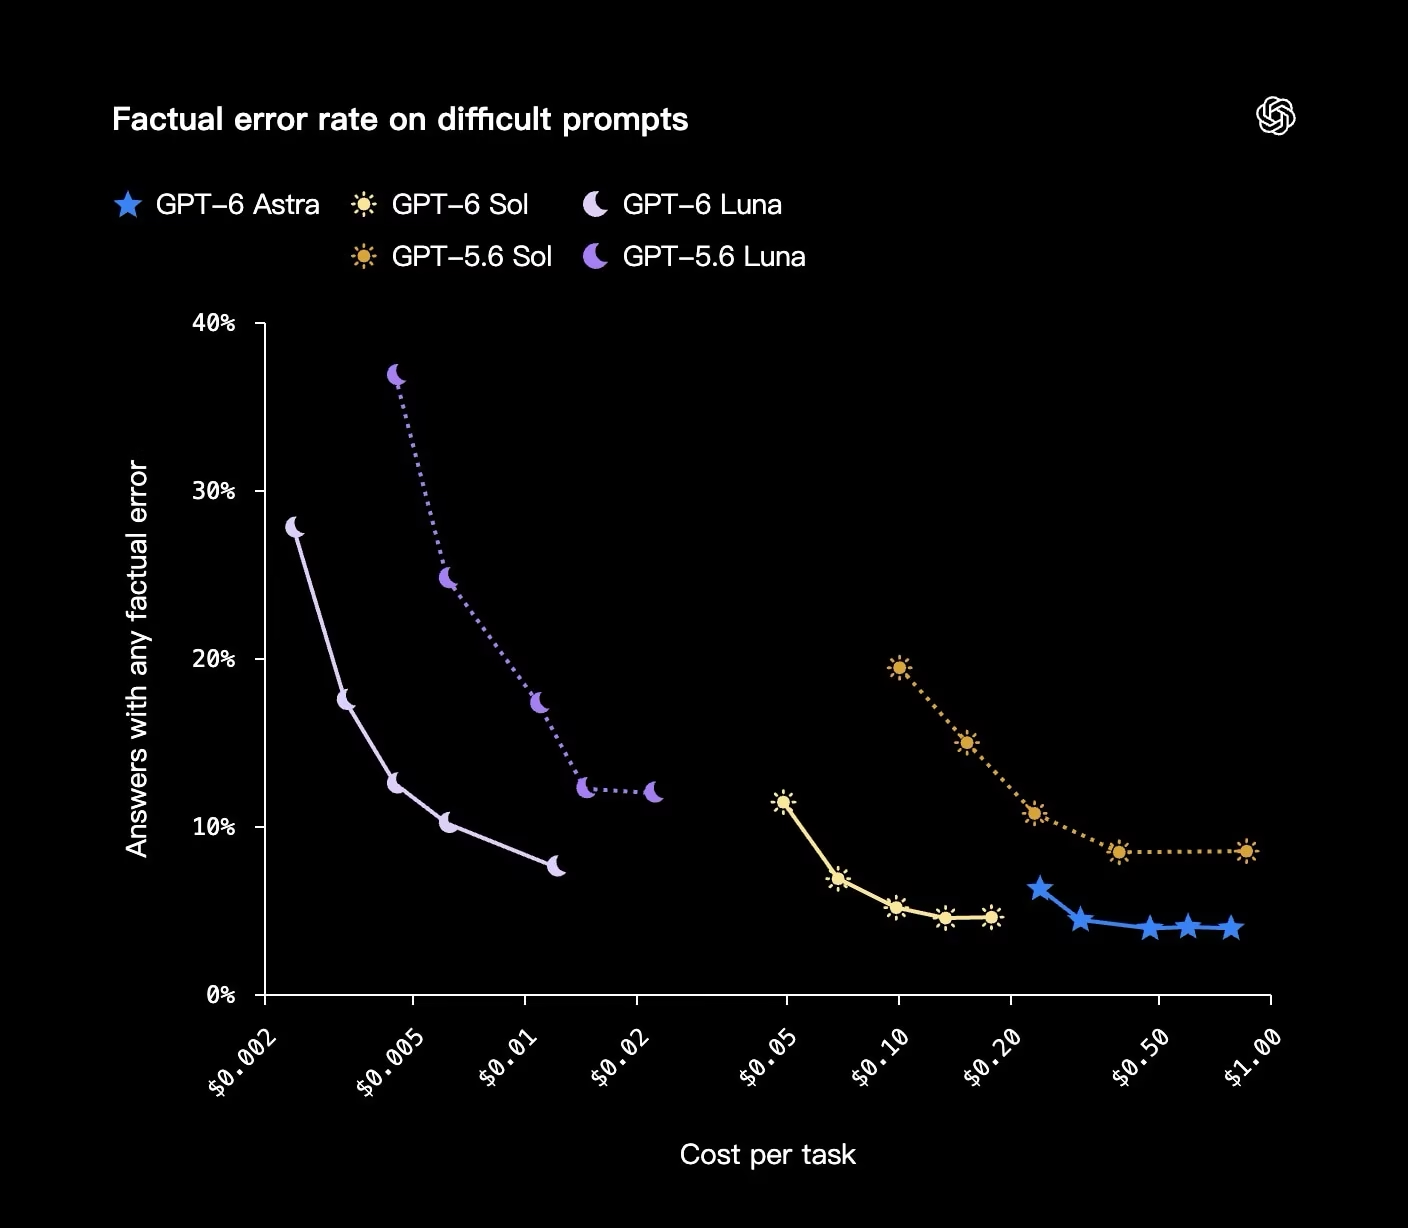
回答的实用价值始终建立在事实准确的基础之上,GPT-6 Sol 和 Luna 在事实可靠性上,也有稳步提升。基于真实脱敏对话(来自用户标记的模型报错样本)的内部评测显示:
- GPT-6 Sol 的事实错误率比前代直接减半,以远低于 Astra 的成本逼近了后者的可靠性水平。
- GPT-6 Luna 同样进步明显:拉高思考预算后,它能以约百分之一的成本,达到和 GPT-5.6 Sol 相当的准确度。
代码编写
过去一年,编程 Agent 承担的任务在复杂度、覆盖范围和持续时长上都创下新高。OpenAI 内部的代码模型使用量,也呈指数级增长:按 API 目录价计算,中位数研究员每天消耗的 Token 成本已经突破 $600,前 10%(90 百分位)的研究员单日消耗更是超过 $7000。随着编程 Agent 承接的代码工程越来越重,长周期调用的成本结构变得至关重要。GPT-6 Sol 和 Luna 把扎实的代码能力和大幅下调的 API 价格相结合,既给开发者留出了更宽裕的调试空间,也让工程团队更有底气把规模大、复杂度高的开发任务交给 Codex。
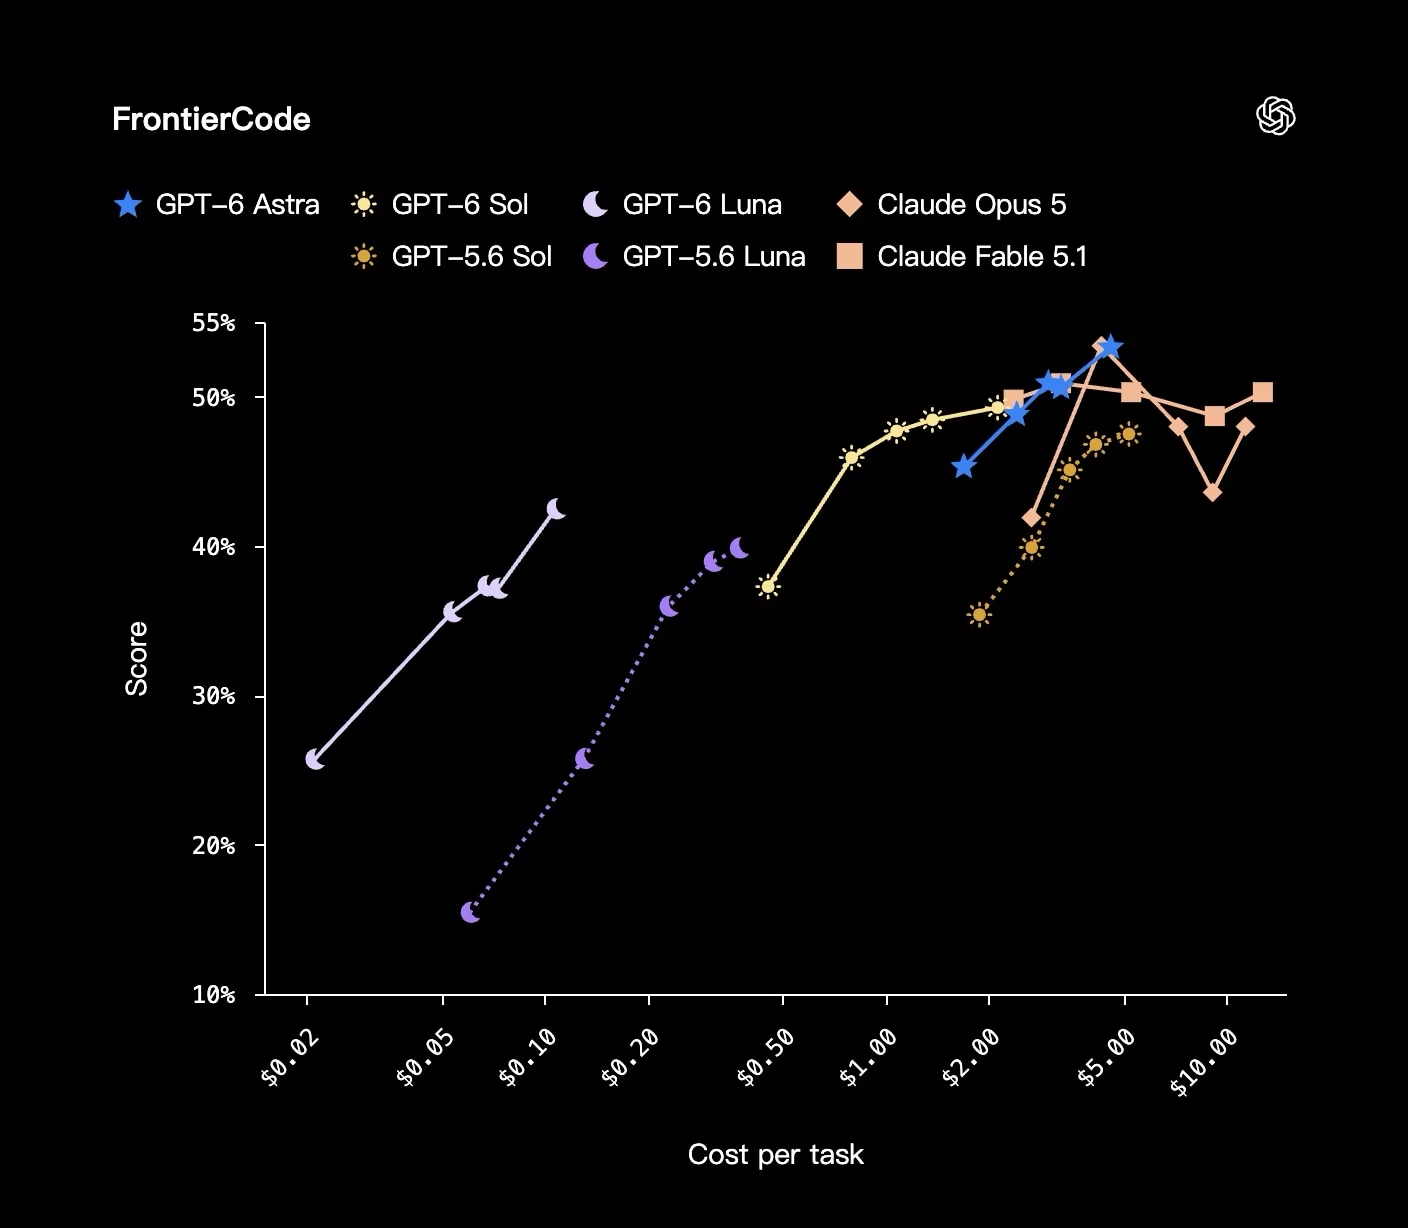
在考察 Agent 生成代码能否「直接合并进真实代码库」的 FrontierCode 评测中,GPT-6 Sol 相比 GPT-5.6 Sol 提升巨大,并能以远低于后者的成本追平极高思考预算下的 Claude Fable 5.1(xhigh)。
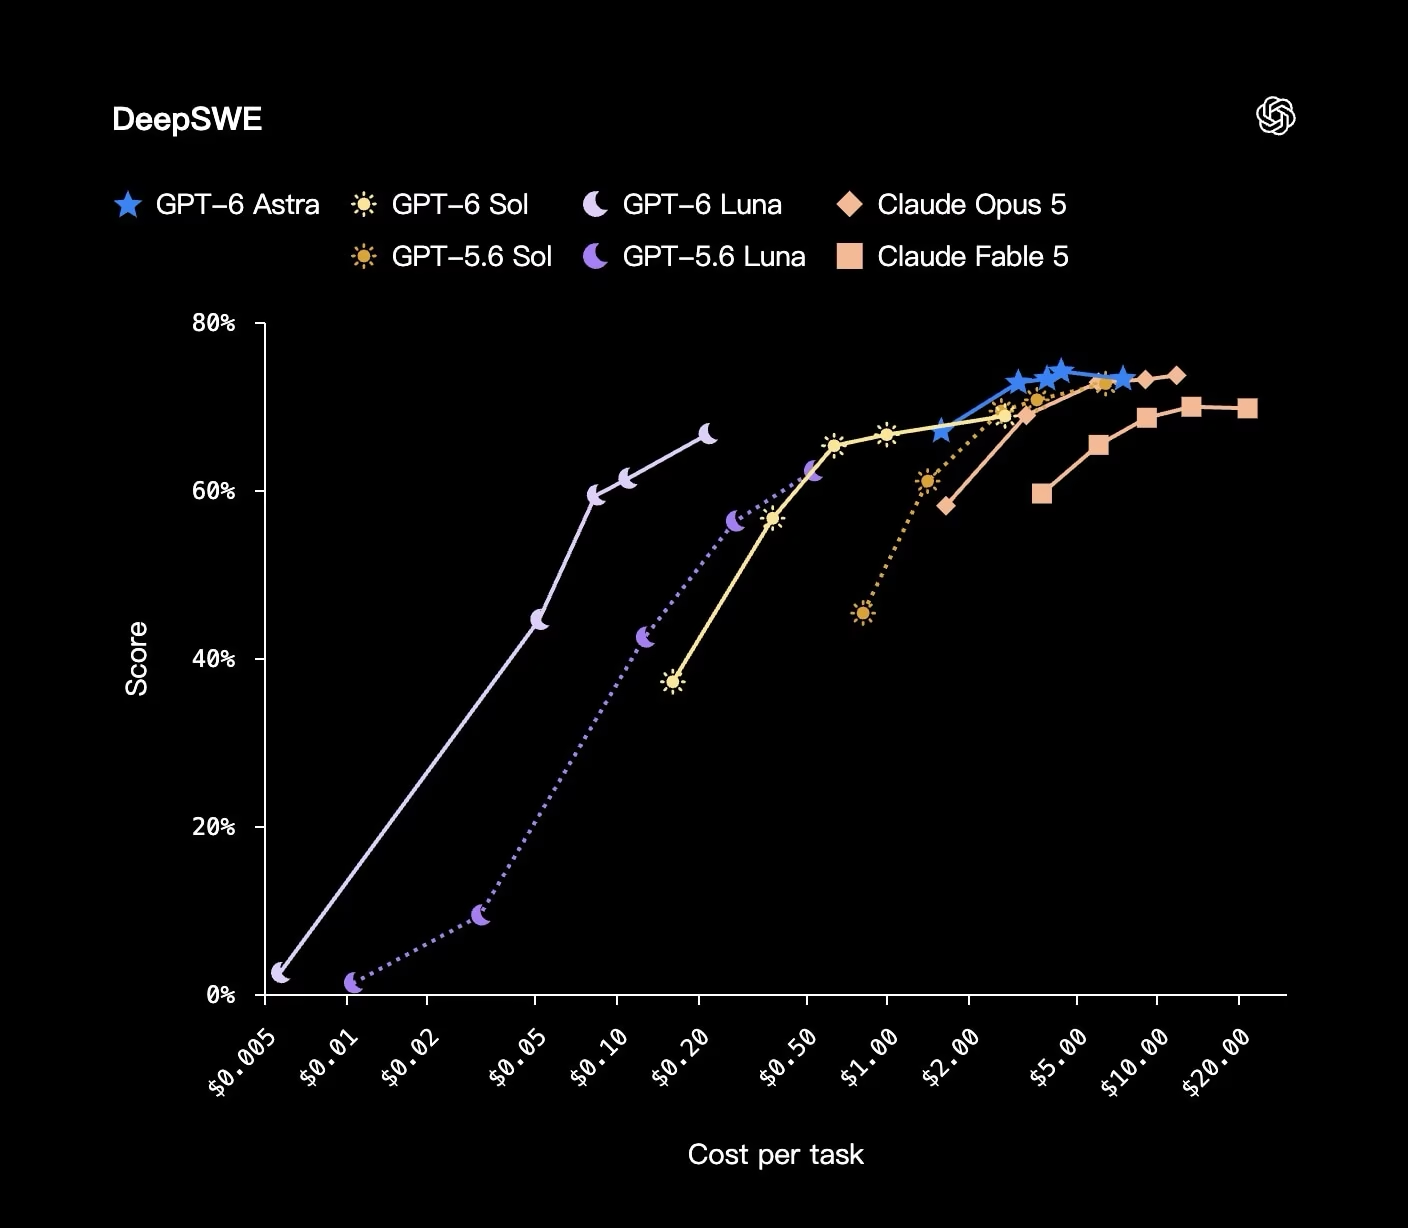
在检验真实代码库复杂软件工程实战能力的 DeepSWE v1.1 中,满血思考模式下的 GPT-6 Sol 拿到了 68.8% 的高分,距离 Claude Fable 5 在该评测中的最高记录(xhigh 思考预算下 69.9%)仅差 1.1 个百分点,单任务成本则减少了约 80%。
满血思考模式下的 GPT-6 Luna 也取得了 66.6% 的分数,足以抗衡中等思考预算(medium effort)下的 Claude Opus 5 与 Fable 5;在同等效果对比下,Luna 的单任务成本比 Opus 5 低了 93%,比 Fable 5 低了 96%。
计算机操控
虽然 GPT-6 Astra 依然是计算机操控综合实力最强的大模型,但 GPT-6 Sol 和 Luna 带来了远超前代的性价比。
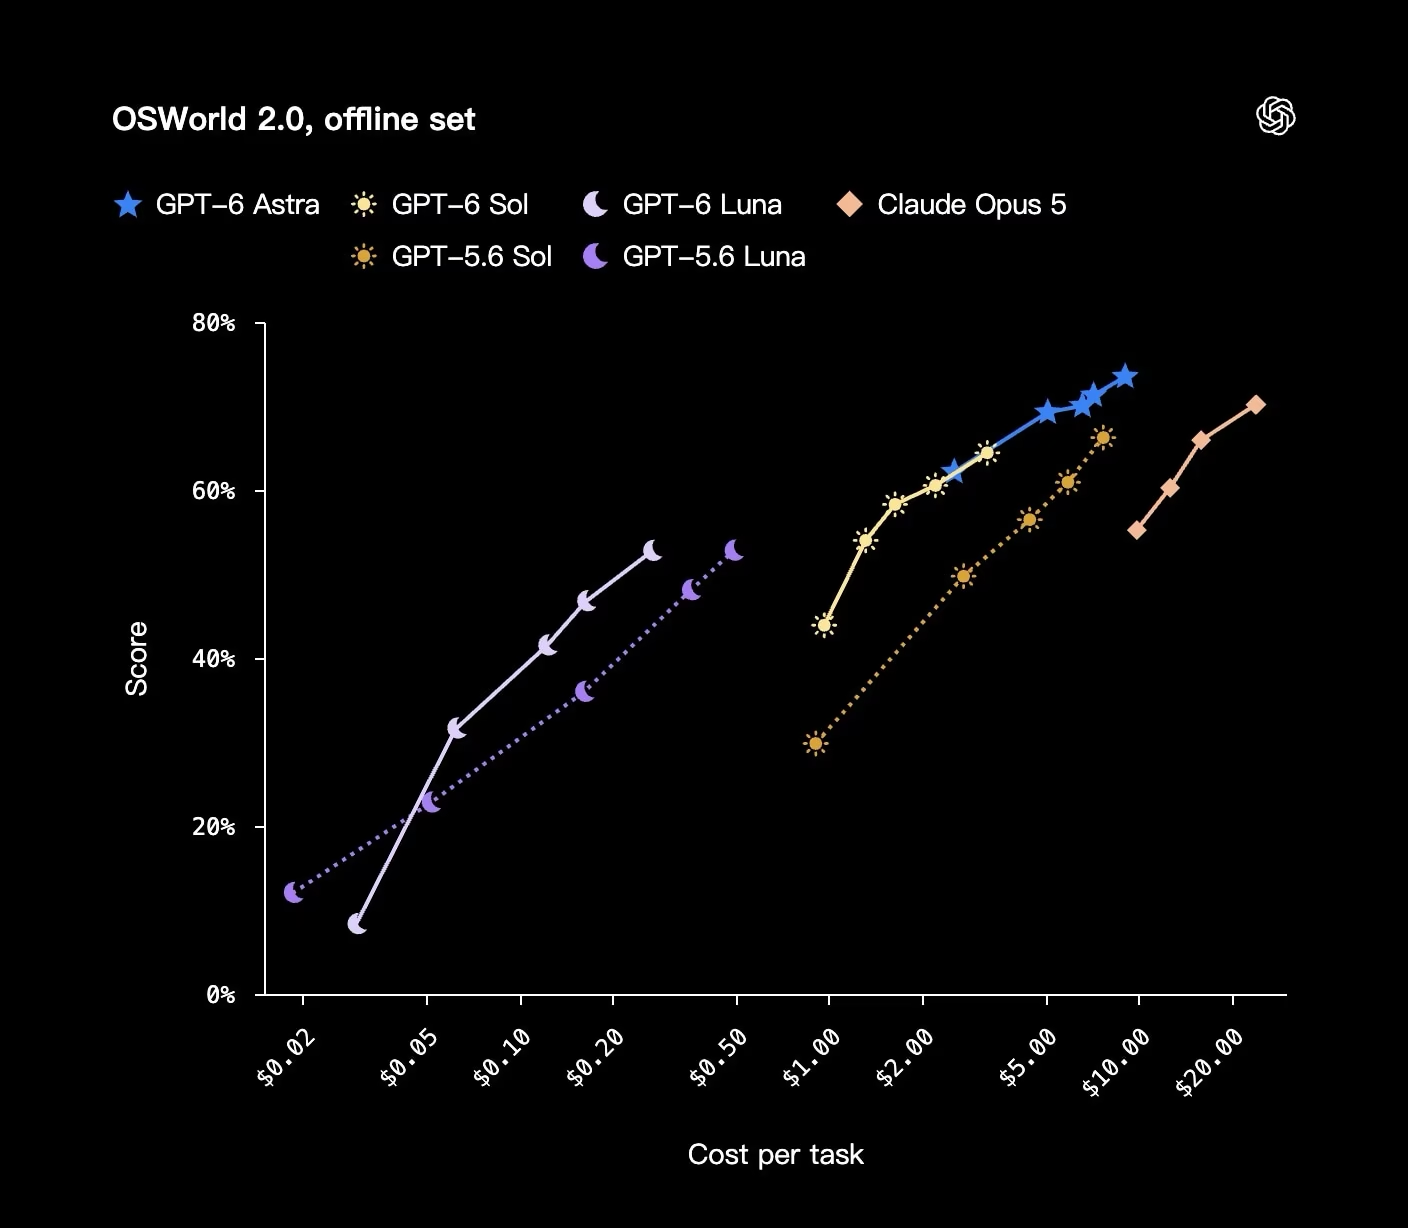
在 OSWorld 2.0 offline 离线基准测试中,极高思考预算下的 GPT-6 Sol 跑出了 60.5% 的成绩,和中等思考预算下的 Claude Opus 5(60.3%)基本持平,单任务成本则缩减了约 80%。GPT-6 Luna(max)仅用十分之一的调用成本,就超过了中等思考预算下的 GPT-5.6 Sol(medium)。
协作交互风格
GPT-6 Astra 广受好评的沟通交互风格也带到了 Sol 和 Luna 中。在技术交流和编码协作场景下,这种变化尤其明显:行文逻辑更清晰,晦涩行话和别扭句式明显减少,低价值的琐碎信息被剔除;在实质内容没有任何减少的前提下,整体回答也更加干脆精炼。
面向 Agent 与长对话的缓存优化
除了下调 Token 单价,新模型还进一步摊薄了重复调用上下文的开销。GPT-6 的提示词缓存(Prompt Caching)进行了底层升级,默认提供更高的缓存命中率,让 Agent 能更顺畅地复用长上下文、缩短首字延迟,并且还有缓存输入 Token 读取费用直降 90% 的优惠。
开发者还获得了更丰富的观测和调优能力:
- 监控与深度诊断:提示词缓存控制台可以直观展示上下文的缓存规模和历史趋势;诊断工具能精准分析缓存未命中的原因,并给出可直接落地的优化建议。
- 动态调整思考预算与工具开关且不破坏缓存:无论是在攻克难题时拉高思考预算、在简单追问时调低预算,还是在任务流转中按需开启或停用外部工具,这两套控制机制现在都会完整保留之前的上下文,不会打断缓存连续性。
- 精准控制前缀缓存范围:开发者可以通过显式断点,自主划定缓存提示词前缀的截止位置,更精细地控制上下文复用逻辑,大幅提升系统吞吐与性能。
GitHub 团队的实测数据显示,过去几个月调用 OpenAI 模型的数十亿次请求中,这些缓存改进让需要全量重新处理的提示词 Token 占比下降了 50% 以上,Copilot 的响应速度明显变快。
模型对齐能力持续精进
GPT-6 Sol 和 Luna 深度承袭了 Astra 在模型对齐上的成熟成果。在各项对齐基准评测中,Sol 与 Luna 相较 GPT-5.6 系列都有明显提升,显著降低了模型在写代码时产生误导性陈述的概率。
完整评测数据请参阅 System Card。
GPT-6 Sol 和 Luna 上线与支持计划
即日起,GPT-6 Sol 与 GPT-6 Luna 正式面向 Plus、Pro、Business、Enterprise 以及 Edu 订阅用户开放,可在 ChatGPT Work 与 Codex 中直接调用;Free 和 Go 用户可在桌面端应用中使用 GPT-6 Luna。两款模型暂未上线个人基础版 Chat。在 OpenAI API 中,对应接口模型名称为 gpt-6-sol 与 gpt-6-luna。
- GPT-6 Sol 和 GPT-6 Luna 已经正式面向 Plus、Pro、Business、Enterprise 以及 Edu 订阅用户开放,可以在 ChatGPT Work 和 Codex 中直接调用。
- Free 和 Go 用户可以在桌面端应用中使用 GPT-6 Luna。
- OpenAI API 对应的接口模型名称为
gpt-6-sol与gpt-6-luna。